登录社区云,与社区用户共同成长
邀请您加入社区
一组练完能看正确率和每题回顾,想再来一轮,点再练一组就行。我自己试过:晚饭先把昨天的错题过一遍,再开新的一组,比摊开本子空耗半小时踏实。想换个节奏,再去挑战:每天有一份当日题,做完就等到明天,本周日历也能看见有没有打卡;一组二十题,大号算式一眼能看清,底下是数字键盘,点确定后对错马上出来,想要提示音和震动也可以开。真希望你装上,先把这一组敲完。我去翻口算工具,不是先弹广告,就是把题锁在会员后面——
从 26.0.0 版本开始,Command Line Tools 集成 arktsdoc 工具,支持通过 arktsdoc 命令行将代码文件中的变量、方法、接口、类等需要对外暴露的信息快速生成相应的参考文档(ArkTSDoc 文档)。options:可选,命令行的配置参数,具体请参考表 1。dir:可选,绝对路径或相对路径。说明:若命令行中输入的路径包含"$""|""<"">""%""^"",""
适配QEMU 11.1.1至鸿蒙PC aarch64环境,攻克三大难点:静默回退的平台识别、OHOS签名与RUNPATH双门槛、CI中Python venv环境焊点。通过3个上游补丁及配方级修复,实现qemu-system-riscv64等7个可执行文件的签名交付。上游104项测试95通,消费者测试全通过,CI问题均定位至环境根因。项目已合并入主干,为鸿蒙PC生态提供RISC-V系统模拟底座。
在讲应用之前,我必须先把这次实战的"头号功臣"请出来——蓝耘元生代 MaaS(Model as a Service,模型即服务)。毫不夸张地说,没有它,就没有这篇文章的诞生。如果说大模型是这个时代最强大的引擎,那么蓝耘元生代 MaaS 就是让你毫不费力就能踩下油门的那个踏板——而且这辆车的油箱(算力)、仪表盘(监控)、变速箱(模型调度)、甚至是整个加油站网络(MCP 生态),全都是蓝耘自己建的。选
Zeek 8.2.1成功移植至鸿蒙PC(aarch64)面临四大核心挑战:私有生成器工具链兼容、libc++标准库缺失(std::ranges/std::pmr)、CMake交叉模式ALIAS展开缺陷,以及测试链断裂。通过76个可移植补丁与2个零平台宏shim,修复10类差异,实现上游单测26/26通过,消费者测试在真机回放4/4
在讲应用之前,必须先聊聊这次实战的核心底座——蓝耘元生代 MaaS(Model as a Service,模型即服务)。毫不夸张地说,正是它让这一切变得如此简单。先简单科普一下 MaaS。传统上,如果开发者想在自己的应用里用上大模型,需要自己做什么?买显卡、搭集群:动辄几十上百万的 GPU 投入,还得考虑机房、散热、运维选模型、做微调:从开源社区挑模型,自己搭建推理框架,处理量化、加速写接口、保稳
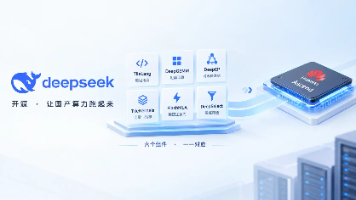
DeepSeek于2026年9月30日开源面向昇腾的六件套,官方称与英伟达组件“一一对应”,但对应仅在接口层,数据在内存中的布局仍需重新适配。其深层逻辑是生态套利:借TileLang把CUDA从默认地基变成可选项,同时与昇腾硬件代际深度绑定。99.8%等性能数字是限定芯片、软件版本和测试形状下的峰值,不能证明昇腾超越英伟达;竞争主战场转向机柜间通信,DeepEP成核心却未附许可证。六件套给的是工具
最近把手机换成纯血鸿蒙(HarmonyOS NEXT)之后,我一直在找一类「小而硬」的系统工具:界面不花哨、能解决实际问题、还不碰隐私。这次把三款用了一段时间的纯本地应用放在一起实测——查看硬件参数的「设备信息鉴」、收拢日常记录的「实用百宝箱」、对比文档差异的「文本比对工具」。它们覆盖系统信息、个人记录、文本处理三个完全不同的场景,共同点是全程在手机本机运行、不联网、数据不上传,而且目前免费。
手机里最常用的其实不是大型办公软件,而是记录、修图、录音这类小需求。在线工具很方便,但笔记、照片、录音都是相对私人的数据,传上去总会犹豫。最近在 HarmonyOS NEXT 上试了三款把数据留在本机的效率应用:实用百宝箱、图匣、爱录音,分别覆盖记录、图像处理和音频处理,全部不申请网络权限,飞行模式下功能完整,目前免费。
做接口联调、处理压缩包、管理各种账号密码,这些事在手机上往往要切好几个在线工具,而在线工具的代价是数据要先上传。最近在 HarmonyOS NEXT 上集中试了四款开发者向的本地工具:XML处理、码匣、密码匣、爱解压。它们的共同点是不申请网络权限,全部计算在手机本地完成,飞行模式下功能完整,目前都免费。这篇记录一下我的实测感受。
手机里占空间最多、格式也最杂的,往往是视频和电子书:相机录的 MOV、各处存的 MKV、下载的 EPUB 和 MOBI……系统自带播放器经常提示“格式不支持”,而在线转换工具又要把文件传到别人的服务器上,心里总不踏实。这阵子在纯血鸿蒙上专门找了一批“只在本地干活”的应用,这次挑出三款定位互补的:管看片的「影匣播放器」、管读书的「爱阅读」、管转码处理的「视频私档转换」。播放、阅读、处理三个场景各归各
— NoteEditor++:从技术到习惯,讲清楚它为什么是鸿蒙 PC / 平板的刚需在鸿蒙 PC 或平板上,你有没有试过用系统记事本打开一份几 MB 的日志?进度条转半天,搜索一个报错关键词,得一遍遍点"查找下一个",找到第 8 个,早忘了前 7 个在第几行。这不是你的问题,是工具没跟上。鸿蒙 PC / 平板 缺的从来不是一个"能打字的东西",而是一个的编辑器。就是冲着这几个痛点来的。
本文复盘了BitMagic 7.13.4在鸿蒙PC(aarch64)上的适配过程:通过调整OSNAME、OS_VER、COMMON_LDFLAGS等变量,解决内核版本空格导致的编译错误与链接入口异常;经分块压力测试,最长任务持续94小时,最终229个测试用例全部通过。附带小示例实测成功,验证了库在鸿蒙PC上可编译运行,为跨平台开发提供实践参考。
手机里最让人不安的三类数据是什么?我盘点了一下:账号密码、财务账目、纸质单据照片。前两者怕同步到云端被拖库,后者怕上传到在线识别网站被存档。最近我在纯血鸿蒙上找了三款完全本地运行的工具——密码匣、无忧离线记账、OCR扫描匣,分别管这三件事,实测一周记录一下体验。
— NoteEditor++ 把 Windows 上那套编辑能力,原样平移到了 HarmonyOS如果你是从 Windows 转到鸿蒙的用户,多半有过这种落差——电脑上用 Notepad++ 改代码、比对配置、看日志,什么都能干;换了鸿蒙手机和平板,系统自带的记事本连语法高亮都没有,打开一份 GBK 老文档满屏乱码,想对比两份配置只能左右来回翻。不是你不会用,是缺一个"平移"过来的工具。
华为轮值董事长徐直军在华为全联接大会上说,昇腾在中国市场份额已达约 50%,英伟达约 8%。对照 2022 年英伟达独占 95%、昇腾不足 3%——四年,近乎镜像的逆转。但这条新闻的正确读法,不是「华为赢了」。更深的事实是:中国市场裂成了两半。50% 和 8% 不是谁取代谁,是谁守住了哪块地。上图:单卡代差用系统规模摊薄——这是华为份额逆转的技术路径。
最近把手机上的办公流程整体搬了一遍,发现真正高频的需求其实很集中:压缩包打不开、PDF要批注、接口报文要转格式。这三件事以前都得依赖在线网站,文件传上去心里没底。这次在纯血鸿蒙上实测了三款本地工具——爱解压、PDF私档编辑、XML处理,把日常场景跑了一遍,记录一下真实体验。
华为最近宣布昇腾950超节点扩容计划,目标是为万亿参数级别的大模型训练提供算力支撑。这个消息之所以重要,是因为它直接关系到中国AI产业的一个核心命题:在高端GPU供应受限的背景下,国产算力底座能否支撑
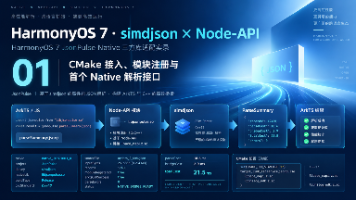
Native 解析很快→ Native → ArkTS 大量对象转换→ 桥接成本重新变大recordsfieldsmaxDepthparseCosterrors也就是说,先证明:simdjson 的核心能力确实已经进入工程,而不是先把跨语言边界做成另一个性能瓶颈。第一组,合法 2.4MB JSON,正常返回摘要。第二组,非法 JSON,errors 不为 0。第三组,ArkTS 传空字符串,Nat
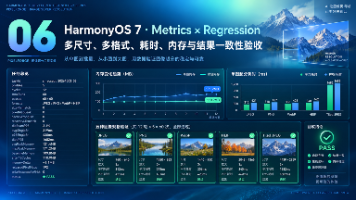
PixelForge第六篇回归测试以固定5类多尺寸、多格式图像(JPEG/PNG/WebP/HEIF/Tiled JPEG)执行12轮,共60次验证,全部通过。测试聚焦真实工程收口:输出尺寸一致性、格式能力探测、单图与瓦片超分耗时(平均319ms,P95 438ms;Tiled P95 1682ms)、内存峰值(最高171.2MB)与循环后基线(+1.1MB)、资源释放(活动资源为0)、缓存误命中
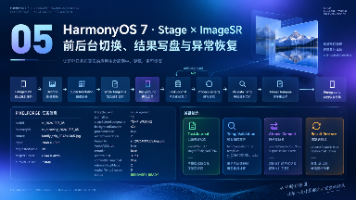
第五篇聚焦超分任务在后台中断后的恢复机制。PixelForge采用“状态持久化”而非依赖后台运行,通过SrTaskJournal记录任务关键信息(如阶段、临时文件路径),确保进程重启后可准确恢复。恢复时先校验临时文件完整性,再原子性提交为正式文件,避免重复计算或读取半成品。核心原则:不依赖运行时对象,以文件证据驱动状态判断,实现可靠、高效、低开销的断点续传。
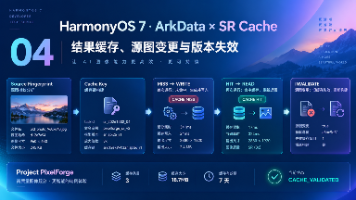
PixelForge 04 版本引入智能缓存机制,通过 sourceHash、scale 与 modelRevision 构建唯一 cache key,实现内容寻址,避免文件名覆盖导致的错误复用。缓存仅存储轻量索引,真实结果保留在文件系统,结合“两阶段提交”确保一致性。首次计算耗时 341ms,二次命中仅 17ms,节省 324ms,且不立即解码大图,降低内存占用。源图变更自动失效旧缓存,支持后台
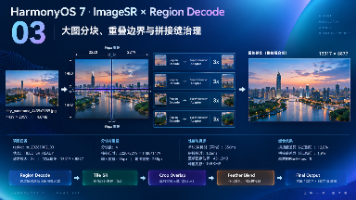
第三篇聚焦大图超分的内存瓶颈,提出“区域分块处理”方案:基于4439×2959大图,采用含96px输入重叠的四块非均分切分策略,通过Region Decode仅加载当前区块,避免整图PixelMap占用。每块独立解码、超分、裁剪重叠区后拼接,输出重叠288px用于羽化融合。峰值内存降至168.9MB,释放8个PixelMap,拼接缝差异从12.8%降至1.9%,实现高效低耗的大图超分。
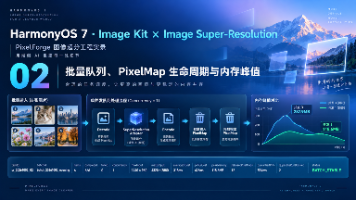
批量图像超分任务中,为避免并发引发的内存峰值与资源竞态,将并行处理改为单并发队列。通过严格控制资源生命周期——每张图独立创建/释放ImageSource与PixelMap、队列仅管理轻量状态、确保“创建→使用→释放”闭环,成功将峰值内存从287.9MB降至118.6MB。同时实现幂等启动、队列等待时间监控,保障稳定性与可复现性。
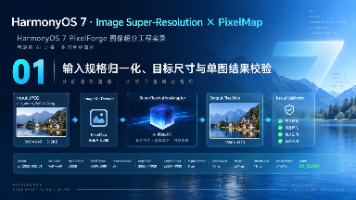
PixelForge 是基于 HarmonyOS 7 API 26 图像超分能力的实验工程,聚焦“低清图→端侧增强→结果校验→保存”链路。首篇核心验证单图生命周期:解码、超分、校验、编码各环节分离,确保异步资源安全释放;统一输入格式为 RGBA_8888,区分 requested 与 actual 尺寸,精准记录每阶段耗时与内存峰值,构建可复用、可回归的超分任务模型。
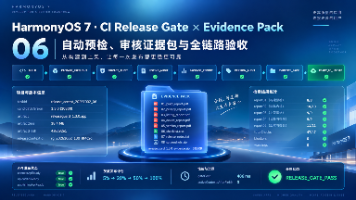
ReleaseGuard 五份独立报告整合为第六阶段“Release Gate”,核心是统一发布上下文验证:通过 releaseContextId 与 artifactHash 确保所有报告针对同一包体。仅当五份报告数据一致、47项检查全通过且无Blocker时,才允许上传。通过后生成证据包(Evidence Pack),包含8个报告文件及索引,用于归档、审批与追溯,实现自动化发布前的可信校验。
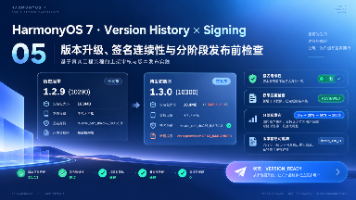
第五篇聚焦版本升级预检,基于前后版本对比实现智能发布判断:校验版本号递增、签名身份连续性、包体增量、权限与设备支持变化,并联动隐私审核与商店文案状态。通过11项检查无阻塞,确认1.3.0可发布,强化了发布流程的完整性与安全性。
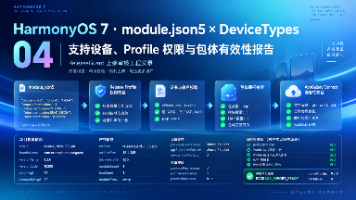
本文介绍ReleaseGuard第04版新增的Package Report,聚焦构建后包体快照的静态校验,提前验证.app包在设备类型、Profile权限、签名、证书状态、包类型等关键维度是否与发布计划一致,覆盖AppGallery Connect常见解析错误(如998、7014、1014等),实现上传前风险拦截,提升发布可靠性。
ReleaseGuard 03 通过构建版本与商店信息的强关联,实现发布前自动校验:基于 snapshot 绑定包名、版本、签名及本地化素材,确保图标、截图、文案、语言完整性与内容分级配置均与当前版本一致。利用 hash 校验防止旧图误用,统一手机平板素材组,前置校验字符长度,明确“已配置”≠“已更新”,推动发布流程从人工核对转向工程化管控,提升上架准确率与效率。
本文介绍基于 ReleaseGuard 工具构建的工程侧隐私合规预检体系,聚焦 AppGallery Connect 审核前的关键风险点:权限声明、敏感权限管理、三方 SDK 披露与隐私政策一致性。通过统一映射表实现 module.json5、功能逻辑、隐私政策、SDK 文档与 AGC 隐私标签的联动校验,确保 10 项检查全部通过,最终达成 PRIVACY_READY 状态,有效避免因信息不一致
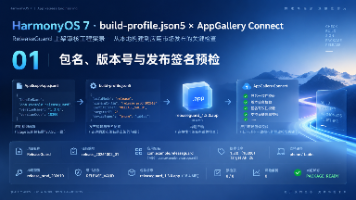
ReleaseGuard 系列首篇:构建前预检机制 在 AppGallery Connect 上架前,通过生成 ReleaseManifestSnapshot 快照,实现包名、版本号、签名配置等核心信息的本地校验。聚焦基础门禁:确保 bundleName 一致、版本号递增、使用正式 release 签名链且证书有效,提前拦截上传失败风险。工具不依赖源码解析,而是基于构建阶段输出的标准化数据,保障检
本文聚焦端侧3DGS重建中Session生命周期管理,针对前后台切换、热保护等现实场景,提出分层处理策略:通过SetRunningMode区分前台/后台运行模式,仅在真正暂停时调用PauseSession;保持同一Session连续重建,避免重复初始化;结合进度与阶段状态(如PAUSED)精准反馈用户,确保恢复时无缝衔接。全链路实现0失败采样、1次暂停/恢复,保障重建任务稳定可靠。
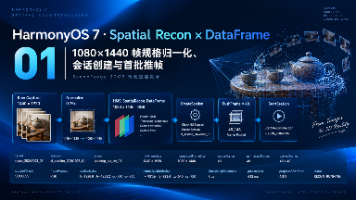
SceneForge 系列首篇:端侧3DGS重建的基石——数据规整 聚焦HarmonyOS 7下3DGS端侧重建,强调输入数据的严格规范。从1440×1920原始帧统一缩放至1080×1440,同步缩放内参(焦距、主点),确保相机模型一致性。所有帧绑定图像、内参、位姿与时间戳,杜绝错帧;时间戳单调性校验前置,避免序列异常。会话创建前完成设备能力检测与workPath配置,保障重建流程稳定可靠。第一
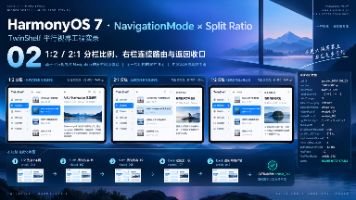
第一组,article_042 打开 compare_workspace。第二组,主区 612vp 不变化。第三组,对照区打开 article_118。第四组,再进入 quote_17,Secondary Depth 到 3。第五组,重复 quote_17 不重复入栈。第六组,关闭 Split,主区不重建。第七组,再打开 Split,恢复 article_118 / quote_17 / 288v
第一组,article_042 进入 reader_workspace。第二组,请求 LANDSCAPE 成功。第三组,Chart → Notes,外层 depth 不变。第四组,Notes 草稿 86 字保持。第五组,Discussion 344vp 保持。第六组,Chart 状态切出去再回来仍保持。第七组,退出容器后恢复外层方向策略。第八组,外层 article_042 / 612vp / d
TwinShelf 03 验证了大屏阅读中全屏沉浸式体验的完整闭环:通过引入 MediaTransition 过渡页,分离阅读与展示语义;提前快照保存文章选中态与滚动位置;按“路由→全屏→加载”顺序推进,确保状态一致性;退出时逆序恢复窗口状态与路由栈,最终实现全屏前后文章、选中、位置、层级零丢失。路由深度回归1,保障主流程稳定。
TwinShelf 在 HarmonyOS 7 大屏环境下,稳定实现平行视界分栏(1:2/2:1)与深层路由的协同。通过统一管理 NavPathStack,确保左栏主选中项不随右栏浏览变化,返回仅退右栏栈,保持阅读上下文一致。关键设计包括:路由去重、比例切换不重推页面、右栏深度仅作状态记录而非独立栈。最终实现比例可变、路由深链、状态稳定,保障真实阅读场景下的流畅体验。
TwinShelf 系列聚焦 HarmonyOS 7 平行视界下的内容阅读应用实现,基于单一 NavPathStack 统一管理路由,确保手机与大屏形态下业务逻辑一致。通过 splitPlaceholder 仅作占位、默认详情由状态触发、选中态独立维护、滚动位置归属文章会话等设计,实现分栏展示与状态同步的稳定解耦。01 篇确立“一条链、一套状态、系统控布局”原则,为后续分栏比例、过渡页、横屏适配等
本文详解了在长图超分任务中,如何通过切块、租约调度、加权融合与资源管控,解决内存峰值过高导致应用崩溃的问题。核心方案包括:边界回拉确保覆盖完整、2并发租约控制资源、按距离加权消除接缝、三本账日志监控质量与资源。最终实现 8192×2048 输出,3268ms 完成,无接缝、无溢出,验证了工程化路径的可行性。
在字体缩放至1.75时,闪控窗因布局错乱导致“发送”按钮消失。通过引入不可变快照机制与80ms静默窗口,确保配置更新的原子性;基于剩余空间动态选择布局模式(FULL/COMPACT/SCROLL_SAFE),避免“新字体+旧高度”冲突;重排后延迟恢复焦点与光标,保障输入连续性;日志按代次追踪,确保各阶段状态一致。最终实现按钮可见、焦点可接、输入不丢失的稳定终态。
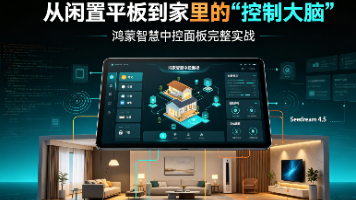
闲置旧平板变身智能中控,仅需鸿蒙系统几行代码。通过三层架构设计——UI层、业务逻辑层、设备接入层,实现跨生态统一控制。抽象统一设备模型,支持米家、HomeKit、Aqara等多品牌设备接入,一键掌控灯光、空调、窗帘、门锁、摄像头,支持场景模式与多端同步。低成本、高扩展,让旧设备焕发新生。
这两年我陆续在纯血鸿蒙手机上试装了不少小工具,个人最在意的一点是:日常天天要用的那几类,最好能完全离线跑,数据不出手机。这篇把我最近一直在用的 5 款整理出来——记账、课程表、视频播放、硬件检测、输入法,覆盖学生党和普通上班族的高频场景,5 款目前都免费。